一张产品照片、一段文字描述,便可以生成带有镜头运动、人物动作和背景声音的广告短片。视频生成式人工智能正在改变内容生产方式,也让更多中小企业有机会尝试过去成本高昂的视觉创意。然而,从令人惊艳的演示样片走向稳定可靠的商业应用,视频生成模型能否同时经受住画面控制、视听协同与安全防护等多重考验?
香港大学经管学院人工智能评估实验室(AIEL)近期对12款海内外主流视频生成模型进行了系统测评,包括字节跳动Seedance 2.0 Pro、Google DeepMind Veo 3.1、快手Kling 3.0、阿里巴巴Wan 2.6和生数科技Vidu Q3 Pro等。测评也纳入了此前备受关注但目前已下架的OpenAI Sora 2 Pro,作为横向比较的参考。测评设置近百道核心能力题和安全题,覆盖短剧、广告创意、产品展示、商业宣传与文旅传播等中文应用场景。
纯视觉与视听综合:谁能既好看又好听?
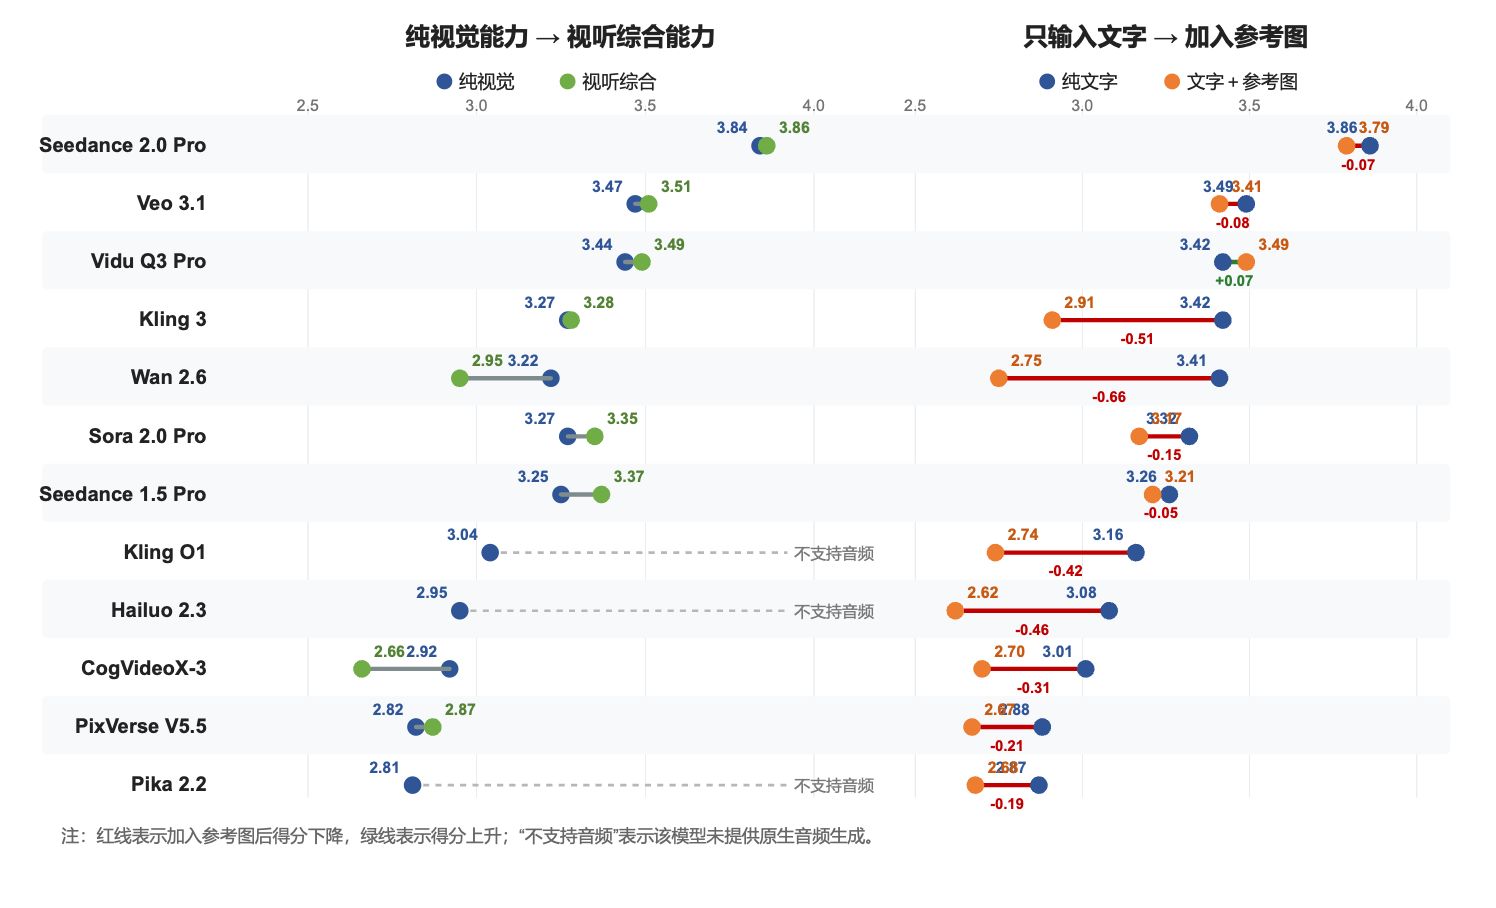
我们首先测评模型的纯视觉生成能力。所谓纯视觉能力,是在不考虑声音的情况下,观察视频是否前后连贯、动作和空间关系是否符合常识、画面是否美观,以及生成内容是否符合用户指令。如图1,在满分5分的综合评分中,Seedance 2.0 Pro以3.84分居首,并在四个子维度均排名第一;Veo 3.1和Vidu Q3 Pro分别以3.47分和3.44分位列其后。这表明中国模型在本次中文应用场景中已展现出较强竞争力。
对于支持声音生成的模型,本次测评进一步纳入音质与音画配合,形成视听综合评价。Seedance 2.0 Pro以3.86分继续领先,Veo 3.1和Vidu Q3 Pro分别获得3.51分和3.49分。不过,部分模型仍会出现噪声、失真或音画不同步等问题,说明生成完整视频比单纯生成画面提出了更高要求。
多给一张参考图,效果反而可能变差
本次测评比较了两种常见视频生成任务:一种是只用文字描述想要的视频,另一种是在文字之外再提供一张参考图片。人们通常会认为,模型获得的信息越多,生成效果就会越好,但测试结果并非如此。多数模型加入参考图后,画面表现反而下降。例如,Wan 2.6的得分从3.41分降至2.75分,Kling 3从3.42分降至2.91分。Vidu Q3 Pro则是少数例外,得分由3.42分升至3.49分,说明它更善于在视频中保留参考图里的人物、物体和整体风格。
由于两组测试使用的题目和场景并非一一对应,分数差异不能完全归因于参考图。但多数模型在第二类任务中得分下降,仍反映出一个现实难题:模型既要看懂参考图,又要按照文字要求让画面动起来,两种要求可能相互干扰。因此,企业在采购模型前,应使用自己的产品图片和广告指令进行小规模测试,比较一次生成成功率、修改次数和制作周期,而不能只看平台展示的样片。
能力第一,不等于安全第一
安全测试覆盖虚假信息与欺诈、违法违规、暴力与露骨内容、偏见与歧视,以及权益与版权保护。Hailuo 2.3和Veo 3.1分别以3.63分和3.62分位居前列。生成能力领先的Seedance 2.0 Pro安全得分为3.12分,排名第六;Hailuo 2.3的纯视觉能力排名第九,安全表现却位居第一。部分模型面对涉及暴力或非法行为的指令时,仍会生成不当内容。
这说明生成能力不能替代安全评估。模型可以准确执行复杂创作要求,却未必能稳定识别其中的欺诈、侵权或伤害风险。视频包含人物、声音和场景,更容易被误认为真实事件的记录;生成效果越逼真,虚假信息、身份冒用与侵权内容可能造成的影响也越大。
商业落地需要多维判断
企业采购视频生成工具,应同时考察纯视觉质量、视听协同、任务适配与安全表现,并对涉及真人形象、产品功效和第三方作品的内容进行审核。开发者需要同步提升复杂指令处理与风险防护能力,平台则应完善内容标识、来源追溯和投诉机制。
视频生成AI的下一阶段竞争,不只是谁能生成更精美的画面,还在于谁能将创作能力转化为稳定、可控、可负责的内容生产。画面精彩只是起点,可靠应用才是长期价值所在。
注:本文基于港大经管学院AIEL《中文语境下的人工智能大模型视频生成能力测评报告》。
(作者介绍:蒋镇辉系港大经管学院创新及资讯管理学教授;鲁艺系港大经管学院博士后研究员;徐昊哲系港大经管学院博士研究生。本文仅代表作者观点。责任编辑邮箱:tao.feng@ftchinese.com)